Wie KI meinen Arbeitsalltag verändert hat, und wo ich bremse
Wenn man den Ankündigungen großer Technologiekonzerne folgt, scheint die Softwareentwicklung vor einer vollständigen Automatisierung zu stehen. Autonome Programmier-Agenten sollen künftig komplexe Softwareprojekte auf Zuruf erstellen, Fehler selbstständig beheben und Entwickler weitgehend ersetzen. Ein paar Textanweisungen, und die Webanwendung steht.
Die Praxis im professionellen Entwicklungsalltag sieht nüchterner aus. Wer täglich produktiven Code für Kunden schreibt, Systeme wartet und für Ausfallsicherheit geradesteht, erlebt ein geteiltes Bild. Werkzeuge wie Claude 3.5 Sonnet oder GitHub Copilot sind aus meinem Alltag nicht mehr wegzudenken. Sie sparen mir bei vielen Routinen messbar Zeit. Gleichzeitig erfordert der Einsatz von Sprachmodellen eine klare Trennlinie zwischen nützlicher Zuarbeit und gefährlicher Leichtgläubigkeit.
Die Entwicklergemeinschaft teilt diese Skepsis. In der Stack Overflow Developer Survey 2024 gaben 76 Prozent der befragten Entwickler an, KI-Werkzeuge im Entwicklungsprozess zu nutzen oder dies zu planen. Allerdings erklärten lediglich 43 Prozent der Befragten, dass sie der Genauigkeit der Ergebnisse vertrauen. 45 Prozent bezeichneten KI-Werkzeuge bei komplexen Aufgaben als schlecht oder sehr schlecht. Diese Kluft zwischen hoher Nutzung und geringem Vertrauen ist kein Zufall. Sie spiegelt eine handwerkliche Erfahrung wider, die jeder Entwickler nach den ersten Experimenten macht.
Wie generative Modelle meinen Alltag beschleunigen
Ich bin kein Skeptiker, der den praktischen Nutzen moderner Sprachmodelle leugnet. Ich nutze KI-Assistenten an jedem Arbeitstag. Sie haben verändert, wie ich an Programmieraufgaben herangehe.
Der größte Hebel liegt bei Routinearbeiten. Ob Schnittstellen in TypeScript typisieren, Hilfsfunktionen für Datumsberechnungen schreiben oder Boilerplate-Code für Datenbankabfragen aufsetzen: Ein Modell liefert in Sekunden einen brauchbaren Entwurf. Früher kostete das manuelle Tipparbeit oder die Suche nach syntaktischen Details.
Ein zweiter Bereich ist das Erkunden unbekannter Bibliotheken oder obskurer Fehlermeldungen. Früher klickte man sich durch Foren oder suchte in GitHub-Issues nach Mustern. Heute beschreibt man das Fehlerbild dem Modell und erhält rasch eine fundierte Hypothese zur Ursache im Protokoll oder in den Abhängigkeiten.
Auch beim Verfassen automatisierter Tests leisten Sprachmodelle gute Dienste. Wer testgetrieben entwickelt, kennt den Aufwand für Randfall-Tests. Ein Modell kann auf Basis einer Funktionssignatur schnell zehn verschiedene Testfälle generieren, inklusive unüblicher Eingabewerte, leerer Zeichenketten oder unerwarteter Nullwerte. Das Nachdenken über die Geschäftslogik nimmt mir das Modell nicht ab, wohl aber das repetitive Tippen der Testgerüste.
Die Illusion von Qualität bei synthetischem Code
Trotzdem übergebe ich dem Modell nicht das Ruder und lasse keine ganzen Komponenten autonom erstellen.
Ein Sprachmodell versteht weder die Architektur Ihres Systems noch die geschäftlichen Folgen eines Fehlers. Es berechnet Wahrscheinlichkeiten für das nächste Token. Deshalb wirkt generierter Code fast immer schlüssig und syntaktisch einwandfrei. Die Fehler liegen tiefer, und sie sind tückisch.
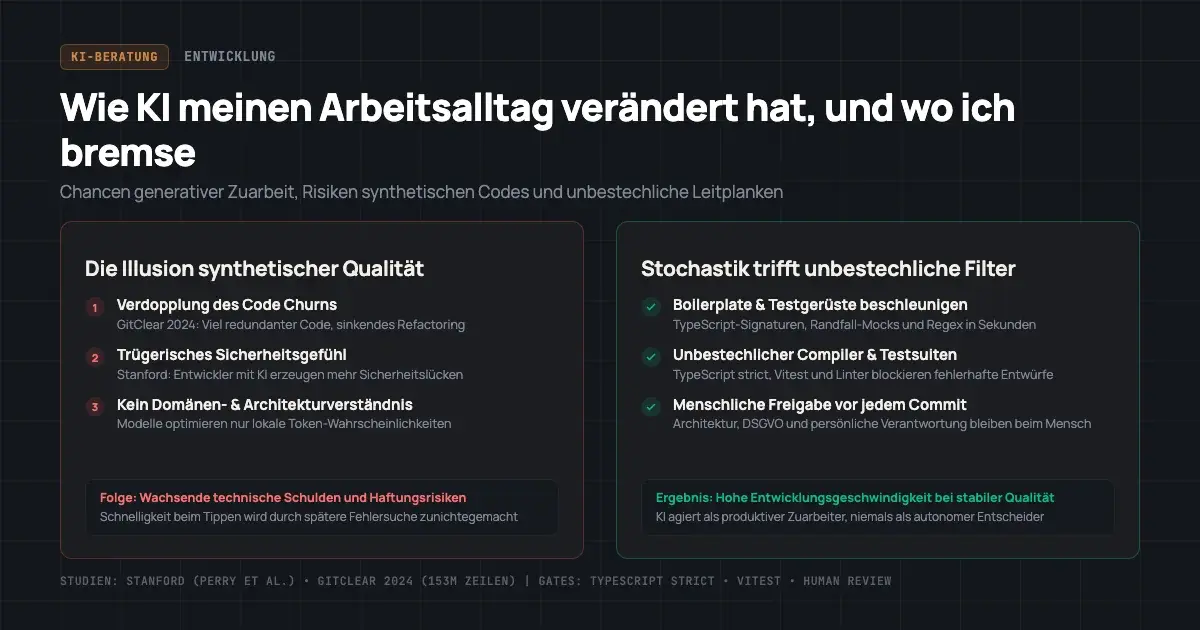
Wissenschaftliche Untersuchungen belegen diese Beobachtung. Eine Studie der Stanford University unter Leitung von Neil Perry („Do Users Write More Insecure Code with AI Assistants?“) untersuchte Entwickler mit und ohne KI-Unterstützung. Das Ergebnis: Entwickler mit KI-Zugriff schrieben signifikant häufiger sicherheitskritischen Code mit handfesten Schwachstellen. Noch beunruhigender war ein psychologischer Nebeneffekt. Die Teilnehmer mit KI-Unterstützung waren deutlich fester davon überzeugt, sicheren Code produziert zu haben, obwohl das Gegenteil zutraf. Die gefühlte Sicherheit stieg, während die tatsächliche Sicherheit sank.
Zu einem ähnlichen Schluss kam eine Analyse des Unternehmens GitClear im Januar 2024 („Coding on Copilot: 2023 Data Suggests Downward Pressure on Code Quality“) an 153 Millionen geänderten Codezeilen aus über 3.400 Repositories. Mit der breiten Einführung von KI-Assistenten stieg der Anteil an rein hinzugefügtem und kopiertem Code drastisch an, während Refactoring, Bereinigung und modulare Wiederverwendung sanken. Die Forscher prognostizierten eine Verdopplung des Code Churns, also jener Zeilen, die weniger als zwei Wochen nach ihrer Erstellung wieder verworfen oder umgeschrieben werden müssen.
Sprachmodelle lösen Probleme bevorzugt durch das Hinzufügen von neuem, redundantem Code, statt bestehende Abstraktionen sauber weiterzuentwickeln. Wer KI-Code ungefiltert übernimmt, sammelt schnell technische Schulden an.
Drei Bereiche, in denen ich die Bremse anziehe
Aus diesen Erfahrungen habe ich klare rote Linien für meine tägliche Arbeit gezogen. Es gibt drei Aufgabenbereiche, in denen ich Sprachmodellen bewusst kein Vertrauen schenke.
1. Systemarchitektur und Domänenmodellierung
Die Entscheidung, wie eine Anwendung modular aufgebaut wird, welche Zustände global verwaltet werden und wo Systemgrenzen verlaufen, lässt sich nicht an eine KI auslagern. Sprachmodelle betrachten immer nur einen begrenzten Kontext. Sie lösen lokale Teilprobleme isoliert, ohne Rücksicht auf die langfristige Wartbarkeit des Gesamtsystems.
Wer eine Website oder eine Webanwendung plant, muss wissen, welche Anforderungen das Geschäftsmodell stellt, wie sich Daten über Jahre verändern und wer die Plattform später pflegt. Der Projekterfolg entscheidet sich an klaren Zuständigkeiten, sauberer Datenstrukturierung und fundierten Architekturentscheidungen, wie mein Leitfaden zu den drei Fragen vor jedem Auftrag zeigt. Eine Architektur aus zusammenkopierten KI-Schnipseln bricht bei der ersten größeren Anforderungsänderung zusammen.
2. Datenschutz und vertrauliche Kundendaten
Vertrauliche Daten gehören niemals in externe Cloud-Prompts. Wer Quellcode mit Zugangsdaten, Auszüge aus Kundendatenbanken oder geschützte Betriebsgeheimnisse in Online-Formulare US-amerikanischer Plattformen kopiert, riskiert Verstöße nach Art. 5 und Art. 6 DSGVO.
Wenn ich für Unternehmen im Rahmen von Web-Engineering arbeite, bleibt die Datenhygiene gewahrt. Für sensible Arbeiten nutze ich vollständig lokale Modelle auf eigener Hardware oder Schnittstellen mit garantierter Null-Speicherung, bei denen Eingaben nicht zur Weiterbildung der Netze verwendet werden. Code, der Geschäftsgeheimnisse oder Daten Dritter berührt, wird anonymisiert oder manuell verfasst.
3. Der letzte Commit vor der Freigabe
In meinen Projekten wandert kein einziger Git-Commit ungeprüft direkt von einer KI in das Haupt-Repository. Jede Zeile Code, die in Produktion geht, lese ich persönlich durch. Ich muss verstehen, was der Code tut, warum er es so tut und welche Nebenwirkungen entstehen können.
Wer Code eincheckt, den er nicht versteht, gibt seine fachliche Urteilsfähigkeit auf. Wenn in Produktion ein Fehler auftritt, haftet nicht das Sprachmodell. Als freiberuflicher Entwickler und Berater trage ich die persönliche Verantwortung für Stabilität und Qualität. Diese Verantwortung lässt sich weder delegieren noch automatisieren.
Unbestechliche Leitplanken statt blindes Vertrauen
Um die Arbeitsgeschwindigkeit von Modellen zu nutzen, ohne die Kontrolle abzugeben, setze ich auf ein bewährtes Prinzip: stochastische Zuarbeit trifft auf unbestechliche, deterministische Prüfungen.
Ein Sprachmodell ist eine stochastische Maschine. Es schätzt Wahrscheinlichkeiten ab. Ein Compiler hingegen schätzt nicht. Er prüft Fakten. Wenn in TypeScript eine Variable den falschen Typ hat, ein Promise nicht aufgelöst wurde oder ein Eigenschaftsname falsch geschrieben ist, bricht der Compiler mit einem Fehler ab.
Deshalb sichere ich jedes Projekt mit einem mehrstufigen Netz aus automatisierten Qualitätsprüfungen ab:
- Strikte Typisierung: TypeScript im Modus
strict: trueverbietet unklare Datentypen und erzwingt präzise definierte Schnittstellen. - Automatisierte Testsuiten: Vitest und Playwright testen Komponenten und Geschäftslogik. Generierter Code muss diese Tests bestehen, bevor er einen Pull Request erreicht.
- Statische Code-Analyse: Linter und Formatter prüfen Codestil, Sicherheitsmuster und veraltete Funktionsaufrufe unerbittlich ab.
- Versionskontrolle in Git: Jede Änderung wird in einem isolierten Branch oder Worktree entwickelt und getestet. Wie wir es auch bei modernen Content-Plattformen handhaben, über die ich kürzlich im Artikel zu Sanity statt Contentful geschrieben habe, ist Schema as Code im Git-Repository der verlässliche Anker gegen unkontrollierte Seiteneffekte.
Dieses Setup erlaubt ein entspanntes Arbeiten mit KI-Werkzeugen. Das Modell darf Entwürfe schreiben, experimentieren und alternative Wege vorschlagen. Am Ende entscheidet jedoch kein Modell über den Erfolg, sondern das deterministische Testgate. Ist der Test grün und hält der Code meinem persönlichen Review stand, wird er übernommen. Schlägt die Prüfung fehl, wird der Entwurf verworfen oder korrigiert.
Die Verantwortung bleibt beim Menschen
Künstliche Intelligenz hat meinen Arbeitsalltag verändert. Sie hat mich schneller gemacht, nimmt mir Routinearbeiten ab und hilft mir, komplexe Sachverhalte rasch zu erfassen. Sie hat mich aber nicht als Entwickler ersetzt, sondern meine Rolle verschoben.
Die wichtigste Fähigkeit eines Softwareentwicklers im Jahr 2026 ist nicht das blinde Heruntertippen von Syntax. Die entscheidende Kernkompetenz liegt im Urteilsvermögen. Es geht darum, schlechten von gutem Code zu unterscheiden, Sicherheitsrisiken frühzeitig zu erkennen, tragfähige Architekturen zu entwerfen und echten Nutzen für Kunden zu stiften.
Der größte Hebel für Softwarequalität liegt nicht im nächsten Prompt, sondern in unbestechlichen Testgates und klaren Architekturregeln. Im Rahmen meiner KI-Beratung unterstütze ich Entwicklerteams dabei, generative Assistenten diszipliniert in bestehende Git- und CI-Workflows einzubinden. Schreiben Sie mir über das Kontaktformular, wenn Sie Leitplanken für Ihr Team aufsetzen möchten.